نموذج ذكاء اصطناعي يضغط 1 جيجابايت من Wikipedia إلى 105 ميجابايت
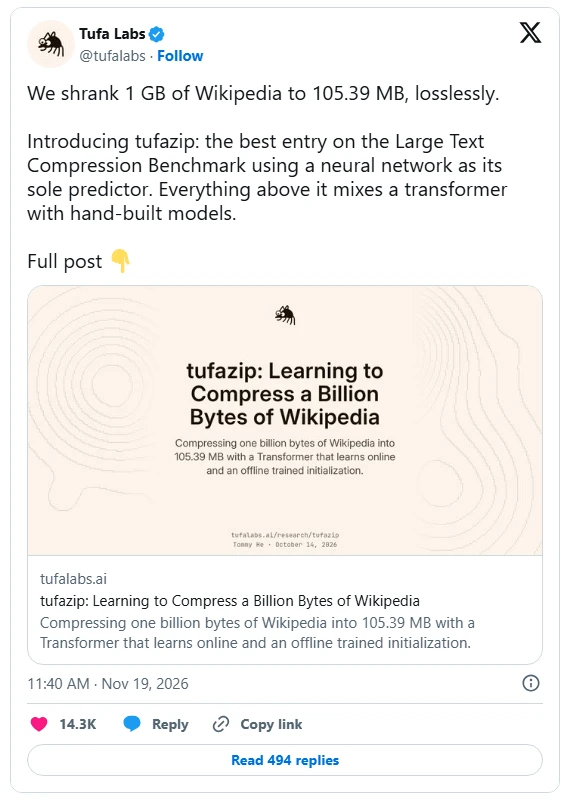
نجح باحث في تطوير أداة ذكاء اصطناعي تحمل اسم tufazip، تمكنت من ضغط 1 جيجابايت من نصوص Wikipedia إلى 105.39 ميجابايت فقط، دون فقدان أي بيانات، لكنها تحتاج إلى بطاقتي NVIDIA B200 ونحو أسبوع لإتمام عملية الضغط أو فك الضغط.
وطور الباحث تومي هي الأداة ضمن مشروع Tufa Labs، باستخدام نموذج Transformer يضم 163 مليون معلمة، ويتعلم أثناء معالجة النصوص بدلًا من الاعتماد على خوارزميات ضغط تقليدية.
وحققت الأداة أفضل نتيجة في اختبار Large Text Compression Benchmark بين الحلول التي تعتمد على الشبكات العصبية وحدها للتنبؤ بالبيانات.
كيف تعمل تقنية الضغط الجديدة؟
وتعتمد tufazip على نموذج يتكون من 12 طبقة، يبدأ بنموذج صغير مدرب مسبقًا يضم 34 مليون معلمة.
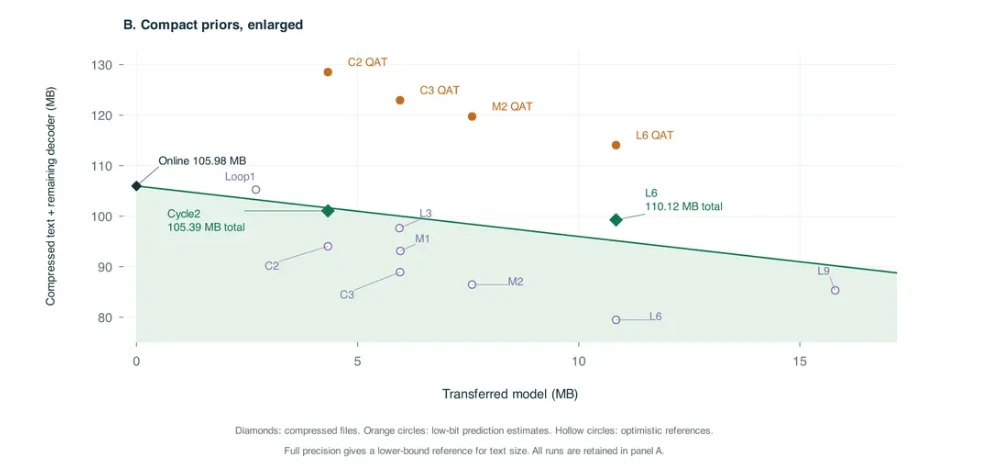
ويبلغ حجم النموذج الأولي 4.33 ميجابايت فقط، بعد تقليل دقة تخزين بياناته، ويحتوي على طبقتين يجري نسخهما لتكوين النموذج الكامل.
وخلال الضغط، يتعلم النموذج تدريجيًا من النصوص التي يعالجها، بينما يعيد برنامج فك الضغط تنفيذ خطوات التعلم نفسها لاستعادة البيانات الأصلية بدقة.
ويشمل الحجم النهائي البالغ 105.39 ميجابايت النص المضغوط والنموذج الأولي والملفات اللازمة لفك الضغط.
واحتلت الأداة المركز الثالث عشر في تصنيف الاختبار بتاريخ 19 نوفمبر، بينما تفوقت عليها 12 أداة تجمع بين الشبكات العصبية وخوارزميات تقليدية.
أسبوع كامل باستخدام بطاقتي NVIDIA B200
رغم كفاءة الضغط، تتطلب الأداة موارد حوسبة ضخمة، إذ استغرق ضغط البيانات نحو 7.3 أيام، وفكها 7.5 أيام، باستخدام بطاقتي NVIDIA B200 ومعالجَي Intel Xeon Platinum 8570.
وللمقارنة، حققت أداة cmix-neif 2.0 حجمًا أصغر بلغ 89.35 ميجابايت، خلال نحو 49 ساعة للضغط، بينما سجلت DNA-4 حجمًا قدره 105.55 ميجابايت باستخدام RTX 4090 خلال 19.8 ساعة تقريبًا.
وأظهرت التجارب أن زيادة حجم النموذج لا تضمن نتائج أفضل، إذ تفوق نموذج يضم 188 مليون معلمة على آخر يضم 267 مليونًا.
كما أدى توسيع نطاق النصوص المستخدمة في التدريب إلى تحسين الضغط بنسبة 1.21% فقط، مقابل زيادة العمليات الحسابية بنسبة 40%.
ولا تزال tufazip مشروعًا بحثيًا غير مخصص للاستخدام التجاري، وتقتصر نتائجه الحالية على ضغط النصوص.